رعایت حریم خصوصی در هوش مصنوعی یکی از حقایق دشوار نوآوری است: با پیشرفت فناوری، خطرات استفاده از آن نیز افزایش مییابد.
برای مثال، ابزارهایی که جمعآوری و تحلیل دادهها را بهبود میبخشند، احتمال ظاهر شدن دادههای شخصی و اطلاعات حساس در مکانهای نامربوط را نیز افزایش میدهند.
این خطر خاص، یعنی خطر حریم خصوصی، بهویژه در عصر هوش مصنوعی شایع است؛ زیرا اطلاعات حساس برای ایجاد و تنظیم دقیق سیستمهای هوش مصنوعی و یادگیری ماشین جمعآوری و استفاده میشوند. و از آنجایی که سیاستگذاران برای رسیدگی به این موضوع با مقررات حریم خصوصی پیرامون استفاده از هوش مصنوعی شتاب میکنند، چالشهای انطباق جدیدی را برای کسبوکارهایی که از فناوریهای هوش مصنوعی برای تصمیمگیری استفاده میکنند، ایجاد مینمایند.
با وجود نگرانیهای مربوط به حریم خصوصی و انطباق، شرکتها همچنان به استقرار مدلهای هوش مصنوعی برای افزایش بهرهوری و ایجاد ارزش ادامه میدهند. بیایید نگاهی دقیقتر به خطرات و محافظتهای حریم خصوصی در هوش مصنوعی که امروزه جامعه و تجارت را تحت تأثیر قرار میدهند، بیندازیم. حریم خصوصی در هوش مصنوعی چه برای یک متخصص و چه برای یک دانشجوی آموزش هوش مصنوعی بسیار حیاتی است.
حریم خصوصی در هوش مصنوعی چیست؟
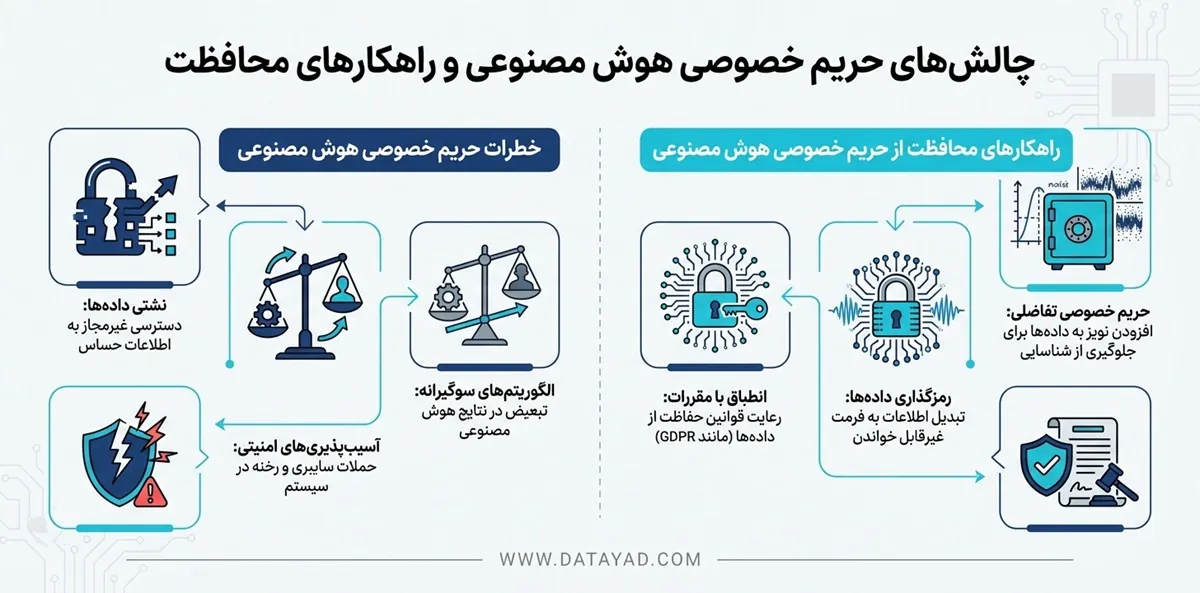
حریم خصوصی در هوش مصنوعی، رویه محافظت از اطلاعات شخصی یا حساس است که توسط هوش مصنوعی جمعآوری، استفاده، به اشتراک گذاشته یا ذخیره میشود.
حریم خصوصی در هوش مصنوعی ارتباط تنگاتنگی با حریم خصوصی دادهها دارد. حریم خصوصی دادهها که با عنوان حریم خصوصی اطلاعات نیز شناخته میشود، اصلی است که بر اساس آن هر فرد باید بر دادههای شخصی خود کنترل داشته باشد. این کنترل شامل توانایی تصمیمگیری درباره نحوه جمعآوری، ذخیرهسازی و استفاده سازمانها از دادههای افراد است. اما مفهوم حریم خصوصی دادهها، پیش از ظهور هوش مصنوعی مطرح بوده و نحوه نگرش مردم به آن، با پیدایش هوش مصنوعی تکامل یافته است.
جنیفر کینگ، از اعضای مؤسسه هوش مصنوعی انسانمحور دانشگاه استنفورد، در مصاحبهای که در وبسایت این مؤسسه منتشر شده است، توضیح میدهد: «ده سال پیش، اکثر مردم حریم خصوصی دادهها را در قالب خرید آنلاین در نظر میگرفتند. آنها با خود میاندیشیدند که شاید برایشان مهم نباشد شرکتها بدانند چه چیزی میخرند یا به دنبال چه چیزی هستند، چرا که گاهی اوقات این موضوع مفید است.»
کینگ در ادامه گفت: «اما اکنون شاهد آن هستیم که شرکتها به سمت جمعآوری همهجانبه دادهها برای آموزش سیستمهای هوش مصنوعی تغییر مسیر دادهاند؛ موضوعی که میتواند پیامدهای عمدهای برای کل جامعه، بهویژه در زمینه حقوق مدنی ما داشته باشد.»
درک خطرات حریم خصوصی در هوش مصنوعی
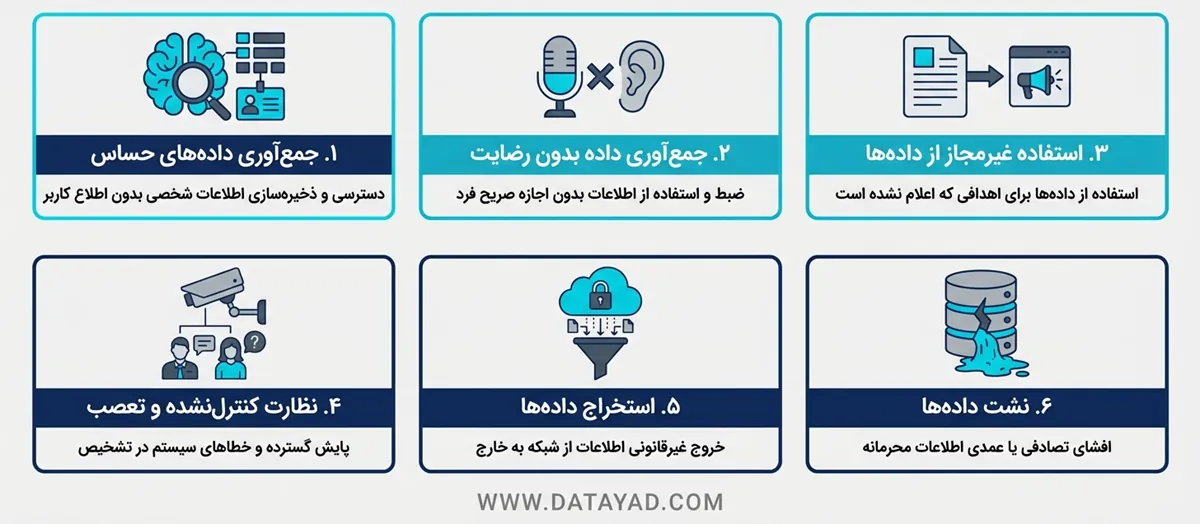
ما اغلب میتوانیم نگرانیهای مربوط به حریم خصوصی در هوش مصنوعی را به مسائل پیرامون جمعآوری دادهها، امنیت سایبری، طراحی مدل و حاکمیت دادهها نسبت دهیم. چنین خطراتی در حریم خصوصی هوش مصنوعی عبارتند از:
- جمعآوری دادههای حساس
- جمعآوری دادهها بدون رضایت
- استفاده از دادهها بدون اجازه
- نظارت کنترلنشده و سوگیری
- خروج غیرمجاز دادهها
- نشت دادهها
جمعآوری دادههای حساس
یکی از دلایلی که هوش مصنوعی احتمالاً خطر بیشتری نسبت به پیشرفتهای فناورانه قبلی برای حریم خصوصی دادهها ایجاد میکند، حجم عظیم اطلاعات موجود است. ترابایتها یا پتابایتها متن، تصویر یا ویدیو به طور معمول به عنوان دادههای آموزشی استفاده میشوند و ناگزیر بخشی از این دادهها حساس هستند: اطلاعات مراقبتهای بهداشتی، دادههای شخصی از سایتهای شبکههای اجتماعی، دادههای مالی شخصی، دادههای بیومتریک مورد استفاده برای تشخیص چهره و موارد دیگر. با جمعآوری، ذخیرهسازی و انتقال دادههای حساس بیش از هر زمان دیگری، احتمال اینکه بخشی از این دادهها در معرض دید قرار گیرند یا به شیوههایی به کار گرفته شوند که حقوق حریم خصوصی را نقض کند، افزایش یافته است.
جمعآوری دادهها بدون رضایت
هنگامی که دادهها برای توسعه هوش مصنوعی بدون رضایت صریح یا اطلاع افرادی که دادهها از آنها جمعآوری میشود به دست میآیند، ممکن است جنجال ایجاد شود. در مورد وبسایتها و پلتفرمها، کاربران به طور فزایندهای انتظار استقلال بیشتری بر دادههای خود و شفافیت بیشتری در مورد جمعآوری آنها دارند. چنین انتظاراتی اخیراً برجسته شد، زیرا شبکه اجتماعی حرفهای لینکدین پس از اینکه برخی کاربران متوجه شدند به طور خودکار در طرحی ثبتنام شدهاند که اجازه میدهد دادههایشان برای آموزش مدلهای هوش مصنوعی مولد استفاده شود، با واکنش شدید مواجه شد.
استفاده از دادهها بدون اجازه
حتی زمانی که دادهها با رضایت افراد جمعآوری میشوند، اگر از این دادهها برای اهدافی فراتر از آنچه در ابتدا اعلام شده استفاده شود، خطرات حریم خصوصی افزایش مییابد. کینگ گفت: «ما شاهد هستیم دادههایی مانند رزومه یا عکسی که برای یک هدف به اشتراک گذاشته یا منتشر کردهایم، اغلب بدون اطلاع یا رضایت ما برای آموزش سیستمهای هوش مصنوعی بازاستفاده میشوند.» برای مثال، در کالیفرنیا، یک بیمار جراحی گزارش داد که متوجه شده عکسهای مربوط به درمان پزشکی او در یک مجموعه داده آموزشی هوش مصنوعی استفاده شده است. این بیمار ادعا کرد که فرم رضایتنامهای را برای پزشک خود جهت گرفتن عکسها امضا کرده، اما نه برای اینکه در یک مجموعه داده گنجانده شوند.
نظارت کنترلنشده و سوگیری
نگرانیهای مربوط به حریم خصوصی در مورد نظارت گسترده و کنترلنشده – چه از طریق دوربینهای امنیتی در خیابانهای عمومی و چه از طریق کوکیهای ردیابی در رایانههای شخصی – مدتها قبل از گسترش هوش مصنوعی مطرح شده بود. اما هوش مصنوعی میتواند این نگرانیهای مربوط به حریم خصوصی را تشدید کند، زیرا مدلهای هوش مصنوعی برای تحلیل دادههای نظارتی به کار گرفته میشوند. گاهی اوقات، نتایج چنین تحلیلهایی میتواند آسیبزا باشد، بهویژه زمانی که سوگیری الگوریتمی (تبعیض) را نشان میدهند. برای مثال در حوزه اجرای قانون، تعدادی از بازداشتهای اشتباه افراد رنگینپوست به تصمیمگیریهای مبتنی بر هوش مصنوعی مرتبط شده است.
خروج غیرمجاز دادهها
مدلهای هوش مصنوعی حاوی گنجینهای از دادههای حساس هستند که میتواند برای مهاجمان جذاب باشد. جف کروم، مهندس برجسته امنیت در آیبیام، در یک ویدیوی اخیر فناوری آیبیام توضیح داد: «این دادهها در نهایت به هدف بزرگی تبدیل میشوند که کسی تلاش میکند به آن ضربه بزند.» بازیگران مخرب میتوانند چنین خروج غیرمجاز دادهها (سرقت داده) را از برنامههای هوش مصنوعی از طریق استراتژیهای مختلف انجام دهند. برای مثال، در حملات تزریق پرامپت، هکرها ورودیهای مخرب را به عنوان پرامپتهای قانونی پنهان میکنند و سیستمهای هوش مصنوعی مولد را وادار میکنند تا دادههای حساس را فاش کنند. به عنوان مثال، یک هکر با استفاده از پرامپت مناسب ممکن است یک دستیار مجازی مبتنی بر مدل زبانی بزرگ را فریب دهد تا اسناد خصوصی را ارسال کند.
نشت دادهها
نشت دادهها به معنای افشای تصادفی دادههای حساس است و برخی از مدلهای هوش مصنوعی در برابر چنین نقضهای دادهای آسیبپذیر بودهاند. در یک مورد خبرساز، ChatGPT، مدل زبانی بزرگ (LLM) از شرکت OpenAI، عناوین تاریخچه مکالمات سایر کاربران را به برخی کاربران نشان داد. خطرات برای مدلهای هوش مصنوعی کوچک و اختصاصی نیز وجود دارد. به عنوان مثال، شرکتی در حوزه مراقبتهای بهداشتی را در نظر بگیرید که یک برنامه تشخیصی داخلی مبتنی بر هوش مصنوعی را بر اساس دادههای مشتریان خود میسازد. آن برنامه ممکن است به طور ناخواسته اطلاعات خصوصی مشتریان را برای سایر مشتریانی که به طور تصادفی از یک پرامپت خاص استفاده میکنند، فاش کند. حتی چنین اشتراکگذاری ناخواسته دادهها میتواند منجر به نقض جدی حریم خصوصی شود.
پیگیری قوانین حفاظت از حریم خصوصی
تلاش سیاستگذاران برای جلوگیری از به خطر افتادن حریم خصوصی افراد توسط پیشرفتهای فناوری، حداقل به دهه ۱۹۷۰ میلادی بازمیگردد. با این حال، رشد سریع جمعآوری تجاری دادهها و بهکارگیری هوش مصنوعی، نیاز فوری جدیدی را برای تصویب قوانین مربوط به حریم خصوصی دادهها ایجاد کرد. برخی از این قوانین عبارتند از:
مقررات عمومی حفاظت از دادهها (GDPR) اتحادیه اروپا
مقررات GDPR چندین اصل را تعیین میکند که کنترلکنندگان و پردازشکنندگان داده هنگام کار با دادههای شخصی ملزم به رعایت آنها هستند. بر اساس اصل «محدودیت هدف»، شرکتها باید هدف مشخص و قانونی برای هر دادهای که جمعآوری میکنند، در نظر داشته باشند. آنها باید این هدف را به اطلاع کاربران برسانند و تنها حداقل میزان داده مورد نیاز برای همان هدف را جمعآوری کنند.
شرکتها همچنین باید از دادهها به صورت عادلانه استفاده کنند. آنها موظفند کاربران را در جریان پردازش دادههای شخصی قرار دهند و از قوانین حفاظت از دادهها پیروی کنند. بر اساس اصل «محدودیت ذخیرهسازی»، یک شرکت تنها تا زمانی که هدفش محقق نشده است، باید دادههای شخصی را نزد خود نگه دارد و پس از آن، دادهها باید حذف شوند.
قانون هوش مصنوعی (AI) اتحادیه اروپا
قانون هوش مصنوعی اتحادیه اروپا که به عنوان نخستین چارچوب قانونی جامع جهان برای هوش مصنوعی شناخته میشود، برخی از کاربردهای هوش مصنوعی را به طور کامل ممنوع کرده و برای سایر موارد، الزامات سختگیرانهای در زمینه حاکمیت، مدیریت ریسک و شفافیت اعمال میکند.
اگرچه قانون هوش مصنوعی اتحادیه اروپا به طور خاص رویههای ممنوعه جداگانهای برای حریم خصوصی در هوش مصنوعی ندارد، اما این قانون محدودیتهایی را بر استفاده از دادهها اعمال میکند. رویههای ممنوعه هوش مصنوعی عبارتند از:
- اسکرپینگ (جمعآوری داده) غیرهدفمند تصاویر چهره از اینترنت یا دوربینهای مداربسته برای پایگاههای داده تشخیص چهره؛
- استفاده مجریان قانون از سیستمهای شناسایی بیومتریک از راه دور و بیدرنگ در اماکن عمومی (مگر در مواردی که استثنایی وجود داشته باشد و مجوز قبلی از یک مرجع قضایی یا اداری مستقل دریافت شده باشد)
سیستمهای هوش مصنوعی با ریسک بالا باید از الزامات خاصی پیروی کنند، مانند اتخاذ رویههای دقیق حاکمیت داده برای اطمینان از اینکه دادههای آموزشی، اعتبارسنجی و تست، معیارهای کیفی مشخصی را برآورده میکنند.
مقررات حریم خصوصی در ایالات متحده
در سالهای اخیر، قوانین مربوط به حریم خصوصی دادهها در حوزههای قضایی مختلف آمریکا اجرایی شدهاند. از نمونههای آن میتوان به قانون حریم خصوصی مصرفکنندگان کالیفرنیا و قانون حریم خصوصی و امنیت دادههای تگزاس اشاره کرد. در مارس ۲۰۲۴، ایالت یوتا «قانون سیاست و هوش مصنوعی» را تصویب کرد که نخستین قانون ایالتی مهمی محسوب میشود که به طور خاص حاکمیت بر استفاده از هوش مصنوعی را هدف قرار داده است.
در سطح فدرال، دولت ایالات متحده هنوز قوانین ملی جدیدی برای هوش مصنوعی و حریم خصوصی دادهها اجرا نکرده است. با این حال، در سال ۲۰۲۲، دفتر سیاست علم و فناوری کاخ سفید (OSTP) «طرحی برای منشور حقوق هوش مصنوعی» منتشر کرد. این چارچوب غیرالزامآور، پنج اصل را برای هدایت توسعه هوش مصنوعی ترسیم میکند که شامل بخشی اختصاصی درباره حریم خصوصی دادهها است و متخصصان هوش مصنوعی را تشویق میکند تا برای استفاده از دادهها، رضایت افراد را جلب کنند.
اقدامات موقت چین برای مدیریت خدمات هوش مصنوعی مولد
چین از نخستین کشورهایی است که مقررات مربوط به هوش مصنوعی را وضع کرده است. در سال ۲۰۲۳، چین «اقدامات موقت برای مدیریت خدمات هوش مصنوعی مولد» را صادر کرد. طبق این قانون، ارائه و استفاده از خدمات هوش مصنوعی مولد باید «به حقوق و منافع مشروع دیگران احترام بگذارد» و ملزم است که «سلامت جسمی و روانی دیگران را به خطر نیندازد و حقوق چهره، شهرت، افتخار، حریم خصوصی و اطلاعات شخصی دیگران را نقض نکند.»6
بهترین روشهای حریم خصوصی در هوش مصنوعی
سازمانها میتوانند رویکردهای حریم خصوصی در هوش مصنوعی را برای کمک به انطباق با مقررات و ایجاد اعتماد در میان ذینفعان خود تدوین کنند. توصیههای OSTP شامل موارد زیر است:
- انجام ارزیابیهای ریسک
- محدود کردن جمعآوری دادهها
- دریافت و تأیید رضایت
- پیروی از بهترین شیوههای امنیتی
- ارائه حفاظت بیشتر برای دادههای حوزههای حساس
- گزارشدهی در مورد جمعآوری و ذخیرهسازی دادهها
انجام ارزیابیهای ریسک
خطرات حریم خصوصی باید در طول چرخه حیات توسعه یک سیستم هوش مصنوعی ارزیابی و برطرف شوند. این خطرات ممکن است شامل آسیب احتمالی به افرادی باشد که کاربر سیستم نیستند، اما اطلاعات شخصی آنها ممکن است از طریق تحلیل پیشرفته دادهها استنتاج شود.
محدود کردن جمعآوری دادهها
سازمانها باید جمعآوری دادههای آموزشی را به آنچه میتوان بهطور قانونی جمعآوری کرد و «مطابق با انتظارات افرادی که دادههایشان جمعآوری میشود» استفاده کرد، محدود کنند. علاوه بر چنین حداقلسازی دادهها، شرکتها باید جدولهای زمانی برای نگهداری دادهها ایجاد کنند، با این هدف که دادهها در اسرع وقت حذف شوند.
دریافت رضایت صریح
سازمانها باید مکانیسمهایی را برای «رضایت، دسترسی و کنترل» دادهها در اختیار عموم قرار دهند. اگر مورد استفادهای که منجر به جمعآوری دادهها شده تغییر کند، باید رضایت مجدد اخذ شود.
پیروی از بهترین شیوههای امنیتی
سازمانی که از هوش مصنوعی استفاده میکند باید بهترین شیوههای امنیتی را دنبال کند تا از نشت دادهها و فرادادهها (متادیتا) جلوگیری شود. چنین شیوههایی ممکن است شامل استفاده از رمزنگاری، ناشناسسازی و مکانیسمهای کنترل دسترسی باشد.
ارائه حفاظت بیشتر برای دادههای حوزههای حساس
دادههای حوزههای خاص باید تحت حفاظت اضافی قرار گیرند و تنها در «بافتهای دقیقاً تعریفشده» استفاده شوند. این «حوزههای حساس» شامل بهداشت، اشتغال، آموزش، عدالت کیفری و امور مالی شخصی است. دادههای تولید شده توسط کودکان یا درباره آنها نیز حساس تلقی میشوند، حتی اگر در یکی از حوزههای ذکر شده قرار نگیرند.
گزارشدهی در مورد جمعآوری و ذخیرهسازی دادهها
سازمانها باید به درخواستهای افراد برای آگاهی از اینکه کدام بخش از دادههایشان در یک سیستم هوش مصنوعی استفاده میشود، پاسخ دهند. سازمانها همچنین باید به طور پیشفعال گزارشهای خلاصه عمومی را در مورد نحوه استفاده، دسترسی و ذخیرهسازی دادههای مردم ارائه دهند. در مورد دادههای حوزههای حساس، سازمانها همچنین باید کوتاهیهای امنیتی یا نقضهایی را که منجر به نشت دادهها شده است، گزارش کنند.
ابزارها و برنامههای حاکمیت داده میتوانند به کسبوکارها کمک کنند تا از توصیههای OSTP و سایر بهترین روشهای حریم خصوصی در هوش مصنوعی پیروی کنند. شرکتها میتوانند از ابزارهای نرمافزاری برای موارد زیر استفاده کنند:
- انجام ارزیابیهای ریسک حریم خصوصی روی مدلهایی که استفاده میکنند
- ایجاد داشبورد با اطلاعات مربوط به داراییهای داده و وضعیت ارزیابیهای حریم خصوصی
- فعالسازی مدیریت مسائل مربوط به حریم خصوصی، شامل همکاری بین مالکان حریم خصوصی و مالکان داده
- افزایش حریم خصوصی دادهها از طریق رویکردهایی مانند ناشناسسازی دادههای آموزشی، رمزگذاری دادهها و به حداقل رساندن دادههای مورد استفاده توسط الگوریتمهای یادگیری ماشین.
با تکامل قوانین هوش مصنوعی و حریم خصوصی دادهها، راهکارهای فناوری نوظهور میتوانند به کسبوکارها امکان دهند تا با تغییرات نظارتی همگام شوند و در صورتی که نهادهای نظارتی درخواست حسابرسی کنند، آمادگی داشته باشند. راهکارهای پیشرفته، شناسایی تغییرات نظارتی و تبدیل آنها به سیاستهای اجرایی را خودکار میکنند.
سوالات متداول
آیا هوش مصنوعی میتواند دادههای شخصی ما را بدون اجازه استفاده کند؟
بله، بسیاری از مدلهای هوش مصنوعی با اسکن کردن حجم عظیمی از دادههای موجود در وب، ممکن است اطلاعات حساس افراد را بدون رضایت صریح آنها برای آموزش خود به کار بگیرند.
چه قوانینی برای حفاظت از حریم خصوصی در هوش مصنوعی وجود دارد؟
مقرراتی مانند GDPR در اتحادیه اروپا، قانون هوش مصنوعی اتحادیه اروپا و برخی قوانین ایالتی در آمریکا و قوانین چین، چارچوبهایی را برای مدیریت ریسک و شفافیت در استفاده از دادهها وضع کردهاند.
سازمانها چگونه میتوانند حریم خصوصی دادهها را در هوش مصنوعی رعایت کنند؟
سازمانها باید ارزیابی ریسک انجام دهند، جمعآوری دادهها را به حداقل برسانند، رضایت صریح کاربران را جلب کنند و از شیوههای امنیتی مانند رمزنگاری و ناشناسسازی استفاده کنند.
منظور از نشت دادهها در هوش مصنوعی چیست؟
نشت دادهها یعنی افشای تصادفی اطلاعات حساس کاربران؛ به این صورت که مدل هوش مصنوعی در پاسخ به پرامپتهای خاص، ممکن است دادههای خصوصی افراد دیگر را که در فرآیند آموزش دیده است، فاش کند.