تحلیل سریهای زمانی یکی از پایهایترین و جذابترین مباحث در دنیای آمار و علم داده به شمار میرود. هدف اصلی در این حوزه، شناخت الگوهای پنهان در دادههایی است که در گذر زمان شکل میگیرند تا بتوان بر اساس آنها آینده را با دقت بالایی پیشبینی کرد. زمانی که دادههای متوالی در طول زمان را بررسی میکنیم، با عواملی مثل روندها (Trends)، اثرات فصلی (Seasonal Effects) و ارتباطات متغیر میان دادهها روبهرو میشویم؛ المانهایی که شناخت دقیق آنها برای ساخت مدلهای پیشبینی الزامی است.
دادههای سری زمانی (Time Series) از ثبت منظم اطلاعات در فواصل زمانی یکسان حاصل میشوند و کاربرد بسیار وسیعی در حوزههای متنوع از اقتصاد و بازارهای مالی گرفته تا بهداشت و هواشناسی دارند. در این میان، فصلی بودن (Seasonality) به همان الگوها و رفتارهای تکرارشونده و دورهای گفته میشود که در بازههای مشخص زمانی رخ میدهند؛ پدیدهای که معمولاً از تغییرات آبوهوایی، تعطیلات رسمی یا نوسانات چرخههای کاری سرچشمه میگیرد.
اگر قصد دارید به تسلط عمیقی در تحلیل سریهای زمانی و پیادهسازی کاربردی مدلهای پیشبینی برسید، بهرهگیری از مسیرهای آموزشی ساختاریافته مثل آموزش علم داده با پایتون به شما کمک میکند تا این مهارتها را به شکلی اصولی و حرفهای بیاموزید.
فصلی بودن در سری زمانی به چه معناست؟
مفهوم فصلی بودن (Seasonality) به تکرار منظم الگوها در بازههای زمانی معین (مانند ماهانه، فصلی یا سالانه) اشاره دارد. این رفتارها اغلب به دلایلی چون تحولات جوی، مناسبتها، نوسانات رفتار خرید کاربران یا روندهای ادواری بازار شکل میگیرند.
برای درک بهتر، به این نمونههای آشنا دقت کنید:
- جهش چشمگیر خرید پوشاک و هدایا در آستانه عید نوروز
- پیک مصرف برق شبکه در ماههای گرم تابستان
- افزایش فروش بلیط و رزرو هتلها در بازههای تعطیلات تابستانی
کشف این الگوها در ابتدای کار ضروری است؛ چرا که عدم شناسایی رفتار فصلی میتواند مدل نهایی را گمراه کند و اجازه ندهد روند بنیادین دادهها به درستی کشف و مدلسازی شود.
در بخشهای بعدی، گامبهگام نحوه شناسایی و پاکسازی اثر فصلی بودن را با کد پایتون پیادهسازی میکنیم.
چرا شناسایی فصلی بودن دادهها اهمیت دارد؟
در پروژههای واقعی علم داده، چند هدف کلیدی برای بررسی رفتار فصلی در دادههای سری زمانی وجود دارد:
- شناسایی الگوها (Pattern Detection): درک چرخههای مکرر به تحلیلگر بینش عمیقتری درباره چرایی تغییرات میدهد و تحلیل دقیقتری از آینده فراهم میکند.
- بهبود کیفیت پیشبینی (Forecasting): با جداسازی اثرات فصلی، مدلهای پیشبینی پایدارتر و قابلاعتمادتر عمل میکنند.
- کشف دادههای پرت و ناهنجاری (Anomaly Detection): وقتی الگوی استاندارد رفتار فصلی مشخص باشد، رفتارهای غیرعادی سریعتر به عنوان فرصت یا هشدار شناسایی میشوند.
- تصمیمگیری بهینه در کسبوکار (Optimized Decision-Making): سازمانها با شناخت زمانهای اوج یا افت تقاضا، مدیریت موجودی انبار، بودجهبندی و برنامهریزی نیروی انسانی را با بالاترین بازدهی انجام میدهند.
روشهای حذف فصلی بودن از سری زمانی
برای مدیریت اثر فصلی در دادهها، متداولترین رویکرد استفاده از تفاضلگیری فصلی (Seasonal Differencing) است. دانشمندان داده از این روش برای ایستا (Stationary) کردن سری زمانی استفاده میکنند تا زمینه یادگیری پایدار برای مدلها فراهم شود.
- در این روش، هر مقدار از سری زمانی از مقدار مشابه خود در همان دوره در دورهٔ قبلی کسر میشود.
- به عنوان مثال در دادههای ماهانهای که الگوی تکرار سالانه دارند، مقدار اردیبهشت امسال از مقدار اردیبهشت سال قبل تفریق میگردد.
- این کار نوسانات فصلی را از بین برده و پایداری آماری دادهها را برای الگوریتمهای یادگیری ماشین افزایش میدهد.
- در پایتون میتوان به راحتی با متد
.diff()در پانداس و تعیین دوره تناوب (مثل 12) این تبدیل را اعمال کرد.
پیادهسازی گامبهگام تشخیص فصلی بودن در پایتون
مرحله ۱: فراخوانی کتابخانههای لازم
برای شروع، ابزارهای تحلیلی، بصریسازی و تجزیه سری زمانی را وارد محیط کار میکنیم:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from statsmodels.tsa.seasonal import seasonal_decompose
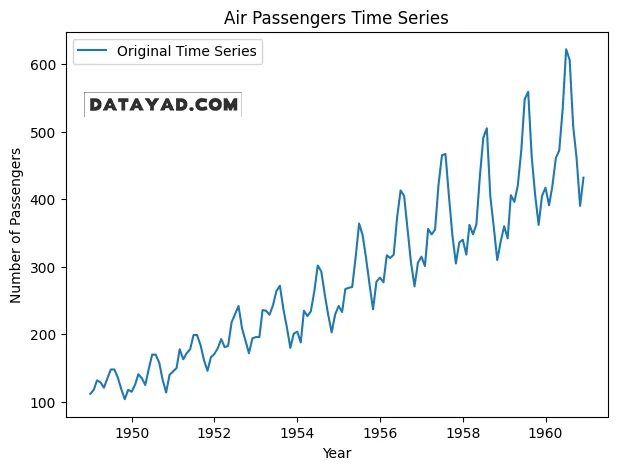
مرحله ۲: بارگذاری دیتاست و رسم نمودار اولیه
در این مرحله، مجموعه داده مربوط به تعداد مسافران خطوط هوایی (AirPassengers) را لود کرده، ستون تاریخ را به عنوان ایندکس قرار میدهیم و سپس برای مشاهده روند کلی و رفتار نوسانی دادهها، نمودار اولیه را رسم میکنیم:
data = pd.read_csv('AirPassengers.csv')
data['Month'] = pd.to_datetime(data['Month'], format='%Y-%m')
data.set_index('Month', inplace=True)

# Plot the original time series data
plt.figure(figsize=(7, 5))
plt.plot(data, label='Original Time Series')
plt.title('Air Passengers Time Series')
plt.xlabel('Year')
plt.ylabel('Number of Passengers')
plt.legend()
plt.show()
خروجی:
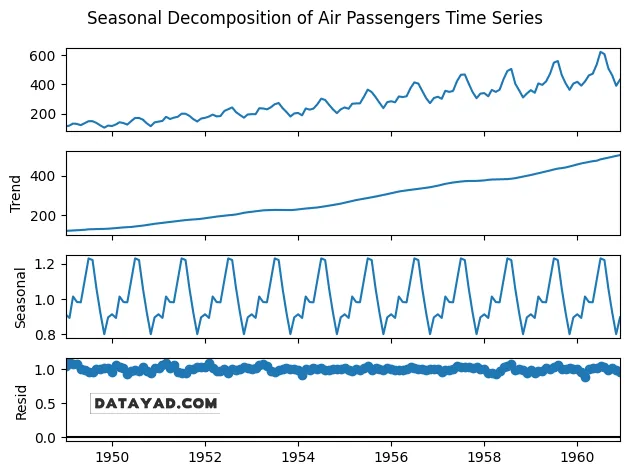
مرحله ۳: تجزیه مؤلفههای سری زمانی (Trend ،Seasonal و Residual)
اکنون سری زمانی را به ۳ بخش تفکیک میکنیم: روند، رفتار فصلی و نویزهای باقیمانده. با توجه به ماهیت رشد دامنهها، از مدل Multiplicative برای تجزیه استفاده میکنیم:
# Decompose the time series into trend, seasonal and residual components
result = seasonal_decompose(
    data, model='multiplicative', extrapolate_trend='freq')
result.plot()
plt.suptitle('Seasonal Decomposition of Air Passengers Time Series')
plt.tight_layout()
plt.show()
خروجی:
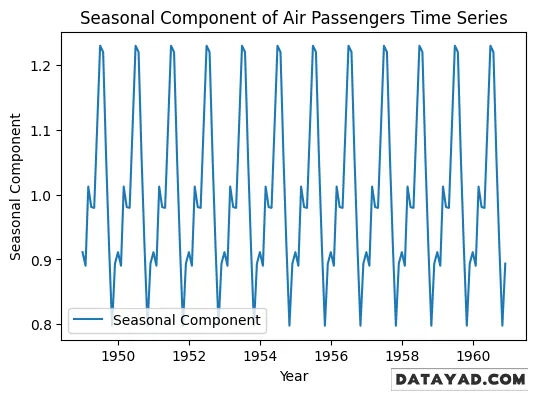
مرحله ۴: نمایش اختصاصی مؤلفه فصلی
برای اینکه ریتم نوسانات تکراری را با وضوح بیشتری ببینیم، مؤلفه فصلی تفکیکشده را به شکل جداگانه مصورسازی میکنیم:
# Plot the seasonal component
plt.figure(figsize=(6, 4))
plt.plot(result.seasonal, label='Seasonal Component')
plt.title('Seasonal Component of Air Passengers Time Series')
plt.xlabel('Year')
plt.ylabel('Seasonal Component')
plt.legend()
plt.show()
خروجی:
مرحله ۵: حذف اثر فصلی از دادهها
برای آماده کردن دادهها جهت استفاده در مدلهای یادگیری، باید فصلی بودن را تعدیل کنیم.
فرمول تفاضلگیری فصلی:
d(t) = y(t) – y(t – m)
پارامترها:
- d(t): مقدار تفاضلگیریشده در زمان t
- y(t): مقدار اصلی در زمان t
- y(t – m): مقدار متناظر در فصل یا چرخه قبل
- m: بازه تناوب فصل (در این مثال دادههای ماهانه، m = 12)
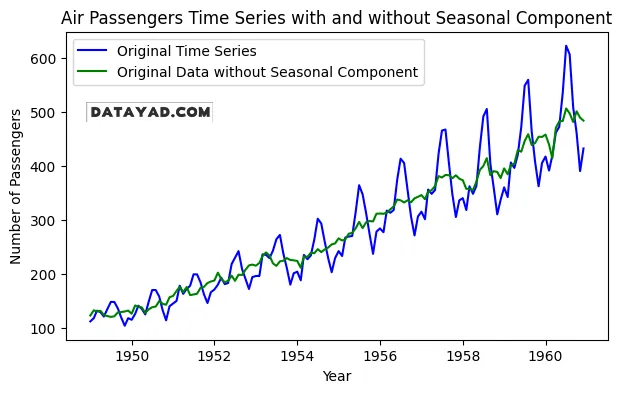
مقایسه سری زمانی اصلی با دادههای پاکسازیشده از اثر فصلی به شکل زیر انجام میشود:
# Plotting the original data and original data without the seasonal component
plt.figure(figsize=(7, 4))

# Plot the original time series data
plt.plot(data, label='Original Time Series', color='blue')
data_without_seasonal = data['#Passengers'] / result.seasonal

# Plot the original data without the seasonal component
plt.plot(data_without_seasonal,
         label='Original Data without Seasonal Component', color='green')
plt.title('Air Passengers Time Series with and without Seasonal Component')
plt.xlabel('Year')
plt.ylabel('Number of Passengers')
plt.legend()
plt.show()
خروجی:
مرحله ۶: بررسی ایستایی با آزمون دیکیفولر تعمیمیافته (ADF)
پس از تعدیل نوسانات فصلی، باید مطمئن شویم سری زمانی به ایستایی (Stationary) رسیده است یا خیر. فرض صفر (Null Hypothesis) این آزمون بر وجود ریشه واحد دلالت دارد؛ یعنی اگر p-value بزرگ باشد، دادهها هنوز ناایستا هستند.
اجرای آزمون در پایتون:
from statsmodels.tsa.stattools import adfuller

adf_result = adfuller(data_without_seasonal)

print('ADF Statistic:', adf_result[0])
print('p-value:', adf_result[1])

# Interpreting the results
if adf_result[1] < 0.05:
    print("The data is stationary (p-value < 0.05).")
else:
    print("The data is not stationary (p-value >= 0.05).")
ADF Statistic: 1.1415289777074211
p-value: 0.9955559262862962
The data is not stationary (p-value >= 0.05).
همانطور که مشخص است، مقدار p-value بسیار بیشتر از 0.05 بوده و نشان میدهد که حذف فصلی بودن به تنهایی کافی نبوده است؛ زیرا هنوز یک روند کلی صعودی (Trend) در دادهها وجود دارد. بنابراین برای رسیدن به ایستایی کامل، نیاز به اعمال تفاضلگیری مرتبه اول داریم.
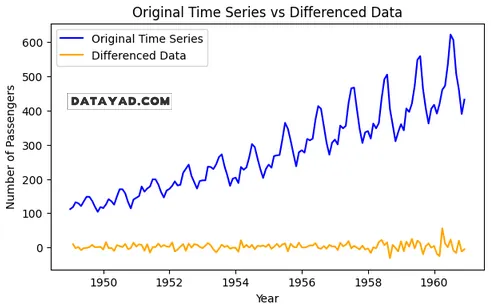
مرحله ۷: اعمال تفاضلگیری برای حذف روند
با یک مرحله تفاضلگیری ساده، روند حاکم بر دادهها را حذف و مجدداً وضعیت ایستایی را چک میکنیم:
data_diff = data_without_seasonal.diff().dropna()
adf_result = adfuller(data_diff)
print('ADF Statistic:', adf_result[0])
print('p-value:', adf_result[1])
ADF Statistic: -2.9058136872756286
p-value: 0.04467610954112502
نتیجه فوقالعاده است: مقدار p-value به 0.0447 کاهش یافته و از سطح معناداری 0.05 کمتر شده است؛ این یعنی سری زمانی ما اکنون ایستا بوده و کاملاً آماده آموزش در مدلهای پیشبینی سری زمانی است.
نمایش دادهها پس از تفاضلگیری نهایی
plt.figure(figsize=(7, 4))

plt.plot(data, label='Original Time Series', color='blue')

plt.plot(data_diff, label='Differenced Data', color='orange')

plt.title('Original Time Series vs Differenced Data')
plt.xlabel('Year')
plt.ylabel('Number of Passengers')
plt.legend()
plt.show()
خروجی نهایی:
پل ارتباطی تحلیل سری زمانی با یادگیری ماشین و علم داده
مراحلی که در این مقاله برای تمیزسازی، تشخیص فصلی بودن و ایستا کردن دادهها طی کردیم، تنها بخش کوچکی از چرخه آمادهسازی داده (Data Preprocessing) است. در پروژههای واقعی علم داده، پس از این مراحل است که کار اصلی آغاز میشود: تغذیه این دادههای تمیز به الگوریتمهای یادگیری ماشین مانند Random Forest، XGBoost یا شبکههای عصبی عمیق نظیر LSTM برای ساخت سیستمهای پیشبینی بلادرنگ.
بدون درک عمیق از نحوه پیشپردازش و مهندسی ویژگیها، حتی قویترین مدلهای یادگیری ماشین نیز خروجی اشتباه تولید خواهند کرد. برای تبدیل شدن به یک متخصص همهجانبه، شما باید پیوستگی میان سه ضلع اصلی یعنی تحلیل داده، علم داده و یادگیری ماشین را به طور کامل درک کنید و بتوانید از دادههای خام به مدلهای تصمیمساز هوشمند برسید.
مسیر تسلط با دوره جامع علم داده و یادگیری ماشین
دوره جامع علم داده و یادگیری ماشین با پایتون دقیقاً با همین رویکرد یکپارچه طراحی شده است تا تمامی مهارتهای لازم برای ورود حرفهای به این بازار را در یک پکیج کامل پوشش دهد. در این دوره، شما از یادگیری مقدماتی پایتون و تحلیل اکتشافی دادهها (EDA) عبور کرده و به مباحث تخصصی مانند پیشپردازش سریهای زمانی، مدلسازی آماری، کار با پایگاههای داده، الگوریتمهای یادگیری نظارتشده و نظارتنشده و پیادهسازی مدلهای یادگیری عمیق مسلط میشوید.
تمامی این سرفصلها در قالب پروژههای واقعی بازار کار پیادهسازی میشوند تا علاوه بر تسلط بر مفاهیم تئوری، توانایی حل مسائل واقعی تجاری و پیشبینی روندهای آینده را با ابزارهای روز دنیا به دست آورید. اگر میخواهید مسیر یادگیری خود را سریع، شفاف و مطمئن طی کنید، مشاهده دوره جامع علم داده و یادگیری ماشین بهترین نقطه شروع برای ورود به سطح حرفهای این تخصص است.
سوالات متداول
آیا برای شروع دوره علم داده و یادگیری ماشین به پیشزمینه برنامهنویسی نیاز است؟
خیر، تمامی مباحث از پایه با آموزش کاربردی برنامهنویسی پایتون، آمار و ریاضیات موردنیاز آغاز شده و گامبهگام شما را به سطح پیادهسازی مدلهای پیشرفته ماشین لرنینگ میرساند.
تفاوت اصلی میان تحلیل داده و یادگیری ماشین در چیست؟
تحلیل داده بر بررسی گذشته، کشف الگوها و ارائه گزارشهای بصری برای تصمیمگیری تمرکز دارد؛ در حالی که یادگیری ماشین از این الگوها برای آموزش الگوریتمهایی استفاده میکند که میتوانند آینده را پیشبینی کرده یا به صورت خودکار تصمیم بگیرند.
چرا یادگیری تحلیل سری زمانی برای متخصصان یادگیری ماشین ضروری است؟
بخش عظیمی از دادههای دنیای واقعی (مانند قیمت سهام، میزان فروش، ترافیک سرور و دادههای هواشناسی) ماهیت سری زمانی دارند و عدم توانایی در پیشپردازش و استخراج روندهای فصلی، عملکرد مدلهای یادگیری ماشین را به شدت کاهش میدهد.