
حوزه یادگیری عمیق (Deep Learning) به لطف ظهور و تکامل سریع مدلهای ترنسفورمر (Transformer Models)، یک تحول بنیادی و عظیم رو تجربه کرده است.
این معماریهای انقلابی نه تنها استانداردها را در پردازش زبان طبیعی (Natural Language Processing) بازتعریف کردهاند، بلکه افقهای خود را برای ایجاد تحول در جنبههای متعدد هوش مصنوعی نیز گسترش دادهاند.
مدل ترنسفورمر، که با مکانیزم توجه (attention mechanisms) و قابلیت پردازش موازی خود شناخته میشود، شروعی بر جهشهای نوآورانه در درک و تولید زبان انسان با دقت و کارایی بالا هستند که پیش از این دستنیافتنی بود.
معماری ترنسفورمر (Transformer) برای اولین بار در سال ۲۰۱۷ در مقاله معروف گوگل با عنوان “Attention is all you need” معرفی شد. این معماری، هسته اصلی مدلهای پیشگامی مانند ChatGPT است و موج جدیدی از هیجان را در جامعه هوش مصنوعی به راه انداخته بود. ترنسفورمرها نقش اساسی در مدلهای زبانی پیشرفته OpenAI داشتهاند و همچنین نقش کلیدی در AlphaStar شرکت DeepMind ایفا کردهاند.
در این دوران تحولآفرین هوش مصنوعی (artificial intelligence)، اهمیت مدل ترنسفورمر برای دانشمندان داده و متخصصان NLP، بیش از حد تصور است.

مدل ترنسفورمر چیست و چگونه کار میکند؟
ترنسفورمرها در ابتدا برای حل مشکل ترجمه ماشینی (machine translation) توسعه یافتند. این یعنی آنها برای حل هر وظیفهای ساخته شدهاند که یک توالی ورودی (input sequence) را به یک توالی خروجی (output sequence) تبدیل میکند. به همین دلیل است که به آنها «ترنسفورمر» (به معنی تبدیلکننده) میگویند.
بیاید قدم به قدم با کارکرد این مدل ها آشنا بشیم.
تعریف و مفهوم مدل های ترنسفورمر
مدل ترنسفورمر یک شبکه عصبی است که بافت (context) دادههای ترتیبی (sequential data) را یاد میگیرد و از آن، دادههای جدید تولید میکند.
به زبان ساده:
ترنسفورمر نوعی مدل هوش مصنوعی است که با تجزیه و تحلیل الگوها در حجم زیادی از دادههای متنی، یاد میگیرد تا مانند انسان متن را درک و تولید کند.
ترنسفورمرها در حال حاضر پیشرفتهترین مدل NLP محسوب میشوند و به عنوان نسخه تکاملیافته معماری رمزگذار-رمزگشا (encoder-decoder) در نظر گرفته میشوند، به همین علت در آموزش هوش مصنوعی جایگاه بسیار ویژه ای دارند. با این حال، در حالی که معماری encoder-decoder عمدتاً به شبکههای عصبی بازگشتی (RNNs) برای استخراج اطلاعات ترتیبی متکی است، ترنسفورمرها به طور کامل فاقد این روش بازگشتی هستند.
پس، آنها چگونه این کار را انجام میدهند؟
آنها به طور خاص برای درک بافت و معنا از طریق تحلیل روابط بین عناصر مختلف طراحی شدهاند و برای انجام این کار، تقریبا به طور کامل به یک تکنیک ریاضی به نام توجه (attention) تکیه میکنند. این مدل ها در حال حاضر در بسیاری از کاربرد های مهم هوش مصنوعی استفاده میشوند و صرفا مربوط به حوزه NLP نیستند.
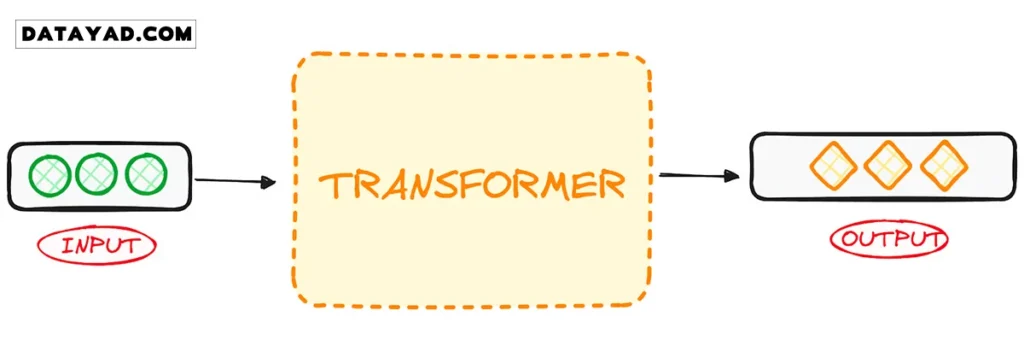
تاریخچه شکلگیری مدل ترنسفورمر
اولین مدل ترنسفورمر در مقاله بسیار تأثیرگذار “Attention is All You Need” تشریح شد.
این مفهوم پیشگام فقط یک پیشرفت نظری نبود، بلکه به سرعت پیادهسازی عملی پیدا کرد، به ویژه در پکیج Tensor2Tensor در تنسورفلو (TensorFlow).
همچنین، گروه NLP دانشگاه هاروارد نیز با ارائه یک راهنمای تشریحی برای این مقاله، که با یک پیادهسازی پایتورچ (PyTorch) همراه بود، به این حوزه نوظهور کمک کرد. معرفی آنها باعث جهش قابل توجهی در این حوزه شد، که اغلب از آن به عنوان هوش مصنوعی ترنسفورمر (Transformer AI) یاد میشود. این مدل انقلابی، سنگ بنای پیشرفتهای بعدی در قلمرو مدلهای زبانی بزرگ (LLMs)، از جمله BERT، را گذاشت. تا سال ۲۰۱۸، این دستاوردها به عنوان یک نقطه عطف در پردازش زبان طبیعی (NLP) مورد ستایش قرار گرفتند.
در سال ۲۰۲۰، محققان در OpenAI از GPT-3 رونمایی کردند. در عرض چند هفته، همهکاره بودن هوش مصنوعی را نیز جابجا کرده و آغازگر عصر جدیدی بوده است.گذار از ساخت آهنگ، طراحی وبسایت و موارد دیگر استفاده کردند و تخیل کاربران را در سراسر جهان به تسخیر خود درآورد.
در مقالهای در سال ۲۰۲۱، پژوهشگران دانشگاه استنفورد به درستی این نوآوریها را مدلهای بنیادی (foundation models) نامیدند و بر نقش اساسی آنها در شکلدهی مجدد هوش مصنوعی تأکید کردند. کار آنها نشان میدهد که چگونه مدل ترنسفورمر نه تنها این حوزه را متحول کرده، بلکه مرزهای دستاوردهای ممکن در هوش مصنوعی را نیز جابجا کرده و آغازگر عصر جدیدی بوده است.
دلیل جایگزینی مدل ترنسفورمر با شبکههای RNN و LSTM
در زمان معرفی مدل ترنسفورمر، RNNها (شبکههای عصبی بازگشتی) رویکرد ترجیحی برای کار با دادههای ترتیبی (Sequential Data) بودند، که مشخصهشان داشتن یک ترتیب خاص در ورودی است.
RNNها شبیه به یک شبکه عصبی رو به جلو (feed-forward) عمل میکنند، اما ورودی را به صورت ترتیبی و هر بار یک عنصر پردازش میکنند.
ترنسفورمرها از معماری (encoder-decoder) که در RNNها یافت میشد، الهام گرفتند. با این حال، مدل ترنسفورمر به جای استفاده از بازگشت (recurrence)، کاملاً مبتنی بر مکانیزم توجه (Attention) است.
ترنسفورمرها علاوه بر بهبود عملکرد RNN، معماری جدیدی برای حل بسیاری از وظایف دیگر مانند خلاصهسازی متن، تولید کپشن تصویر و تشخیص گفتار (speech recognition) ارائه کردهاند.
محدودیتها و مشکلات مدلهای بازگشتی (RNN)
آنها عمدتاً به دو دلیل اصلی برای وظایف NLP ناکارآمد هستند:
۱. پردازش ترتیبی: آنها دادههای ورودی را به صورت ترتیبی، یکی پس از دیگری پردازش میکنند. چنین فرآیند بازگشتی از قابلیت محاسبات موازی که در کارت گرافیک (GPU) طراحی شدهاند، استفاده نمیکند و در نتیجه، آموزش (training) این مدلها بسیار کند است.
۲. مشکل وابستگیهای طولانیمدت: زمانی که عناصر (مثلاً کلمات در یک جمله) از یکدیگر فاصله زیادی دارند، کارایی RNNها به شدت کاهش مییابد. این به آن دلیل است که اطلاعات در هر مرحله (هر کلمه) منتقل میشود و هرچه زنجیره طولانیتر باشد، احتمال از دست رفتن اطلاعات در طول زنجیره بیشتر است.
راهحل مدل ترنسفورمر برای رفع محدودیتها
گذار از شبکههای عصبی بازگشتی (RNNs) مانند LSTM به ترنسفورمرها در NLP، به دلیل همین دو مشکل اصلی و توانایی ترنسفورمرها در حل هر دوی آنها با بهرهگیری از مکانیزم توجه بود:
- ترنسفورمرها میتوانند به کلمات خاص «توجه» کنند، بدون توجه به اینکه چقدر در توالی از هم دور هستند.
- آنها سرعت عملکرد را (به دلیل قابلیت موازیسازی) به شدت افزایش میدهند.
به این ترتیب، ترنسفورمرها به یک جایگزین منطقی برای RNNها تبدیل شدند.
در ادامه، نگاهی به نحوه عملکرد ترنسفورمرها خواهیم انداخت.
بررسی معماری مدل ترنسفورمر (Transformer)
ساختار کلی معماری ترنسفورمر
ترنسفورمرها که در اصل برای ترجمه ماشینی ابداع شدند، در تبدیل توالیهای ورودی به توالیهای خرو یکدیگر فاصله زیادی دارند، کارایی RNNها به شدت کاهش مییابد. این به آن دلیل است که اطلاعات در هر مرحله (هر کلمه) منتقل میشود و هرچه زنجیره طولانیتر باشد، احتمال از دست رفتن اطلاعات در طول زنجیره بیشتر است.
راهحل ترنسفورمر
گذار از شبکههای عصبی بازگشتی (RNNs) مانند LSTM به ترنسفورمرها در NLP، به دلیل همین دو مشکل اصلی و توانایی ترنسفورمرها در حل هر دوی آنها با بهرهگیری از مکانیزم توجه بود:
- ترنسفورمرها میتوانند به کلمات خاص «توجه» کنند، بدون توجه به اینکه چقدر در توالی از هم دور هستند.
- آنها سرعت عملکرد را (به دلیل قابلیت موازیسازی) به شدت افزایش میدهند.
به این ترتیب، ترنسفورمرها به یک جایگزین منطقی برای RNNها تبدیل شدند.
در ادامه، نگاهی به نحوه عملکرد ترنسفورمرها خواهیم انداخت.
نگاهی کلی
ترنسفورمرها که در اصل برای ترجمه ماشینی ابداع شدند، در تبدیل توالیهای ورودی به توالیهای خروجی عملکرد فوقالعادهای دارند. این، اولین مدلی است که برای محاسبه بازنمایی (representations) ورودی و خروجی خود، کاملاً به خود توجهی (self-attention) متکی است و از RNNهای مبتنی بر توالی یا کانولوشن (convolution) استفاده نمیکند. ویژگی اصلی و مرکزی معماری ترنسفورمرها این است که آنها مدل (encoder-decoder) را حفظ کردهاند.
با این حال، هم رمزگذار و هم رمزگشا در واقع دارای چندین لایه هستند (و تعداد لایهها برای هر دو یکسان است). تمام رمزگذارها ساختار یکسانی دارند و ورودی به هر یک از آنها وارد شده و سپس به لایه بعدی منتقل میشود. تمام رمزگشاها نیز ساختار یکسانی دارند و ورودی را از آخرین رمزگذار و رمزگشای قبلی دریافت میکنند.
معماری اصلی ترنسفورمر شامل ۶ رمزگذار و ۶ رمزگشا بود، اما ما میتوانیم این لایهها را به هر تعدادی که بخواهیم تکرار کنیم. پس بیایید فرض کنیم که از هر کدام N لایه داریم.
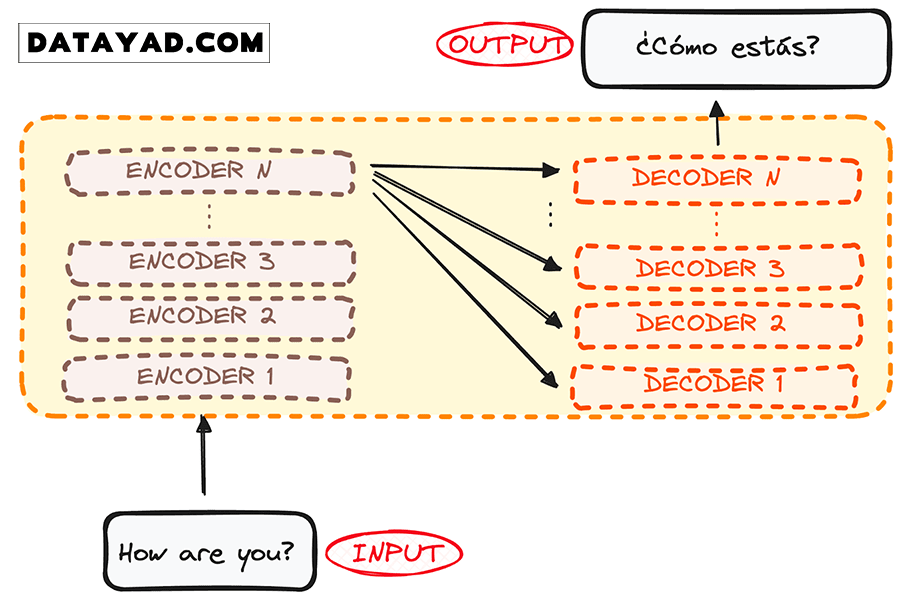
اکنون که درک کلی از معماری کلی ترنسفورمر پیدا کردیم، بیایید برای درک بهتر جریان کاری، روی رمزگذارها و رمزگشاها تمرکز کنیم:
نحوه کار رمزگذار (Encoder) در مدل ترنسفورمر
رمزگذار (Encoder) یک جزء اساسی در معماری ترنسفورمر است. وظیفه اصلی رمزگذار، تبدیل توکنهای ورودی (input tokens) به بازنماییهای بافتمحور (contextualized representations) است. برخلاف مدلهای قبلی که توکنها را مستقل پردازش میکردند، رمزگذار ترنسفورمر، بافت هر توکن را با توجه به کل توالی درک میکند.
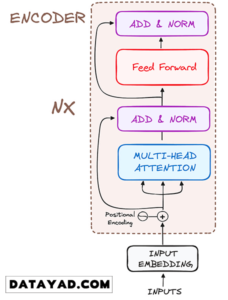 پس بیایید جریان کاری آن را به اساسیترین مراحلش تقسیم کنیم:
مرحله ۱ – تعبیهسازیهای ورودی (Input Embeddings)
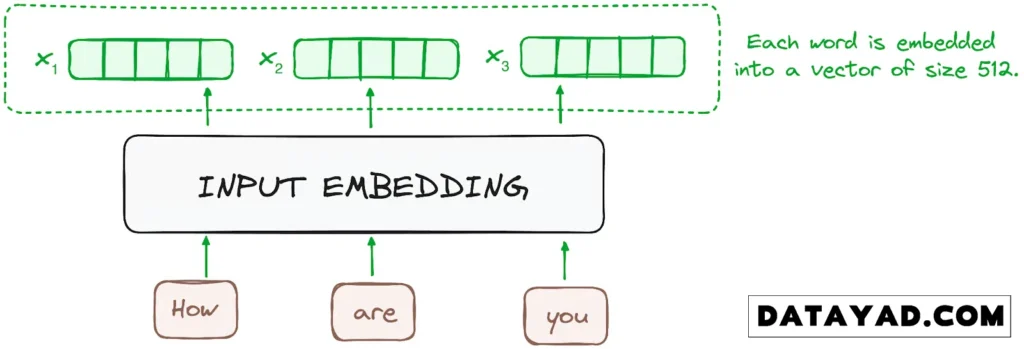
فرآیند تعبیهسازی (Embedding) فقط در پایینترین لایه رمزگذار اتفاق میافتد. رمزگذار کار خود را با تبدیل توکنهای ورودی (input tokens) – که میتوانند کلمه یا زیرکلمه (subword) باشند – به بردار (vector) از طریق (embedding layers) آغاز میکند. این تعبیهسازیها، معنای مفهومی (semantic meaning) توکنها را در خود ذخیره میکنند و آنها را به بردارهای عددی تبدیل میکنند.
تمام رمزگذارها لیستی از بردارها را دریافت میکنند که هر کدام اندازهای ثابت (مثلاً اندازه ۵۱۲) دارند. در پایینترین رمزگذار، این بردارها همان تعبیهسازیهای کلمات (word embeddings) هستند، اما در سایر رمزگذارها، ورودی در واقع خروجی رمزگذار لایه پایینی است.
مرحله ۲ – رمزگذاری موقعیتی (Positional Encoding)
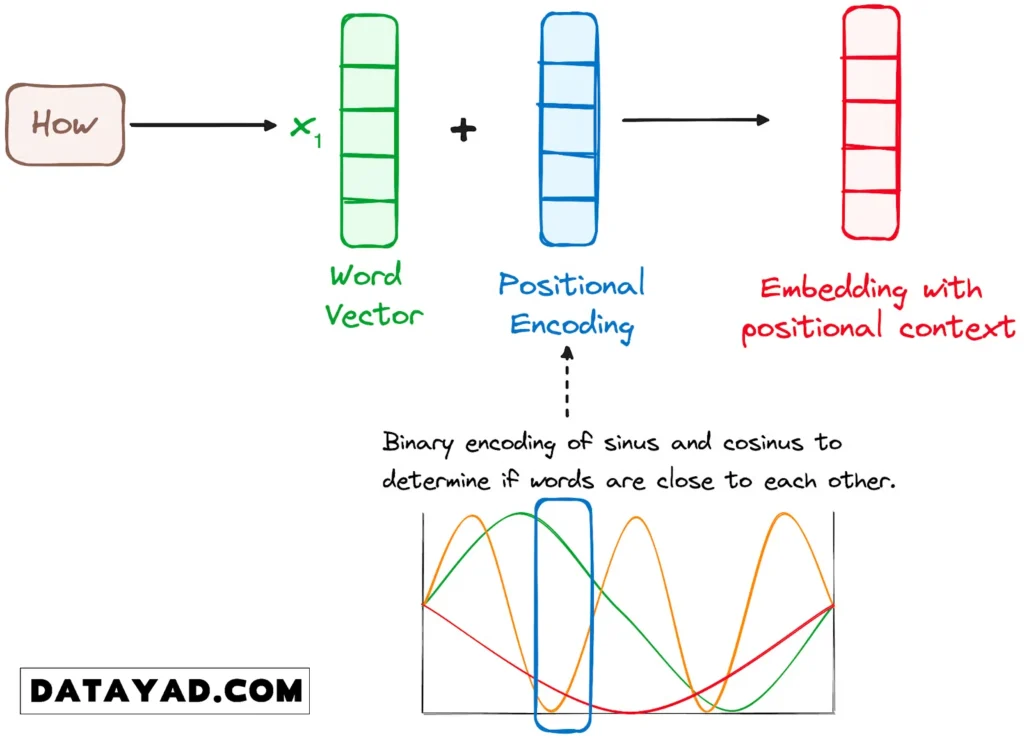
از آنجایی که ترنسفورمرها (Transformers) برخلاف RNNها، مکانیزم بازگشتی ندارند، از رمزگذاری موقعیتی (positional encodings) استفاده میکنند. این رمزگذاریها به تعبیهسازیهای ورودی (input embeddings) اضافه میشوند تا اطلاعاتی درباره موقعیت (position) هر توکن در توالی فراهم کنند. این کار به مدل اجازه میدهد تا جایگاه هر کلمه در جمله را درک کند.
برای انجام این کار، محققان (سازنده مقاله اصلی) پیشنهاد کردند که از ترکیبی از توابع سینوسی و کسینوسی مختلف برای ایجاد بردارهای موقعیتی استفاده شود. این رویکرد، استفاده از این رمزگذار موقعیتی را برای جملاتی با هر طولی ممکن میسازد.
در این روش، هر بُعد از بردار موقعیت، توسط فرکانسها و آفستهای منحصربهفردی از موج سینوسی/کسینوسی نشان داده میشود، مقادیر این بردارها بین -۱ تا ۱ متغیر هستند و به طور مؤثری موقعیت هر کلمه را نشان میدهد.
مرحله ۳ – لایههای رمزگذار
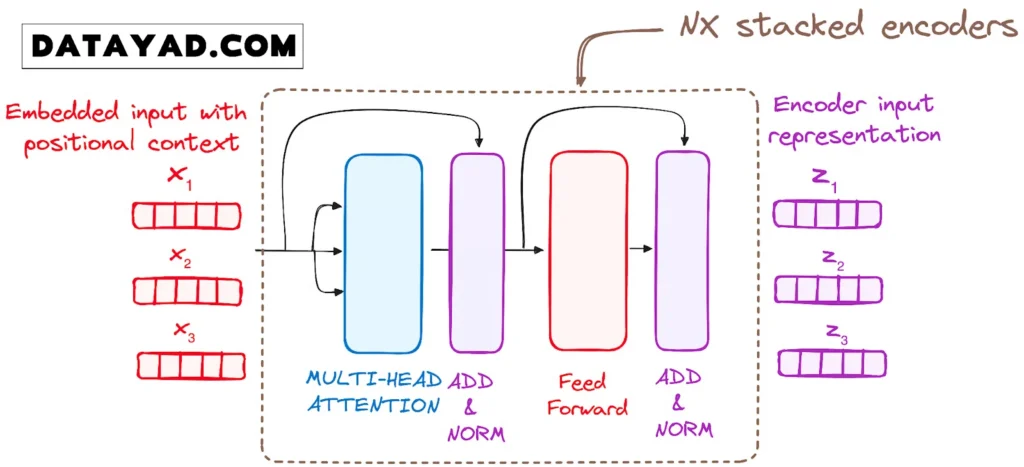
رمزگذار ترنسفورمر (Transformer encoder) از تعدادی لایههای یکسان تشکیل شده است (در مدل ترنسفورمر اصلی، ۶ لایه وجود داشت).
وظیفه لایه رمزگذار این است که تمام توالیهای ورودی را به یک بازنمایی (representation) پیوسته و انتزاعی تبدیل کند، این بازنمایی، اطلاعات آموختهشده از کل توالی را در خود جا میدهد. هر لایه از دو ماژول اصلی تشکیل شده است:
- یک مکانیزم توجه چندگانه (multi-headed attention).
- یک شبکه کاملا متصل (fully connected network).
علاوه بر این دو ماژول، در اطراف هر زیرلایه (residual connections) وجود دارد و به دنبال آن، یک لایه نرمالسازی (layer normalization) انجام میشود.
مرحله ۳.۱ – مکانیزم (Multi-Headed Self-Attention)
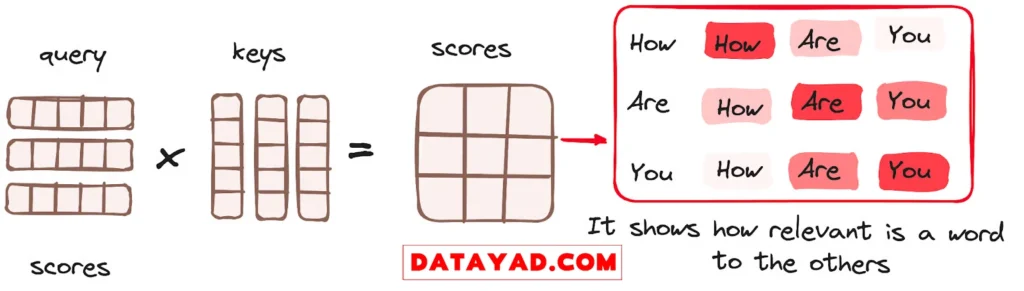
در رمزگذار، توجه چندگانه (multi-headed attention) از یک نوع خاصی از مکانیزم توجه به نام خود توجهی (self-attention) استفاده میکند. این رویکرد به مدل اجازه میدهد تا هر کلمه در ورودی را به کلمات دیگر در همان توالی مرتبط کند. برای مثال، در یک جمله، مدل ممکن است یاد بگیرد که کلمه «are» را به «you» مرتبط سازد.
این مکانیزم به رمزگذار اجازه میدهد تا هنگام پردازش هر توکن، روی بخشهای مختلف توالی ورودی تمرکز کند. امتیازات توجه (attention scores) بر اساس سه بردار محاسبه میشوند:
- کوئری (Query): برداری است که نماینده کلمه یا توکن فعلی (که به دنبال ارتباط میگردد) در مکانیزم توجه است.
- کلید (Key): این نیز یک بردار در مکانیزم توجه است که به هر کلمه یا توکن در توالی ورودی (که بررسی میشود) مطابقت دارد.
- مقدار (Value): هر مقدار به یک کلید مرتبط است و برای ساختن خروجی لایه توجه استفاده میشود. زمانی که یک کوئری و یک کلید به خوبی با هم مطابقت داشته باشند (یعنی attention scores بالایی بگیرند)، مقدارِ متناظر با آن کلید، در خروجی نهایی تأکید بیشتری پیدا میکند.
بر اساس تجربه ما در دیتایاد، مبحث ماتریسهای Query، Key، Value و درک بصری مکانیزم Multi-Head Attention، یکی از چالشبرانگیزترین نقاط یادگیری برای دانشجویان است و اغلب افراد در شهود ریاضی و فلسفه شکلگیری این بردارها دچار ابهام میشوند. به همین دلیل ما در دوره پردازش زبان طبیعی و مدلهای زبانی بزرگ (NLP & LLM)، چندین جلسه مجزا را به باز کردن گامبهگام این معماری، شبیهسازی محاسبات و بررسی شهودی نحوه ارتباط کلمات اختصاص دادیم. بازخورد فوقالعاده دانشجویان پس از این جلسات نشان داد که اگر این الگوریتمها با مثالهای ملموس زبانی و به دور از پیچیدگیهای غیرضروری فرمولی آموزش داده شوند، تسلط بر هسته اصلی ترنسفورمرها بسیار سریعتر و عمیقتر رقم خواهد خورد.
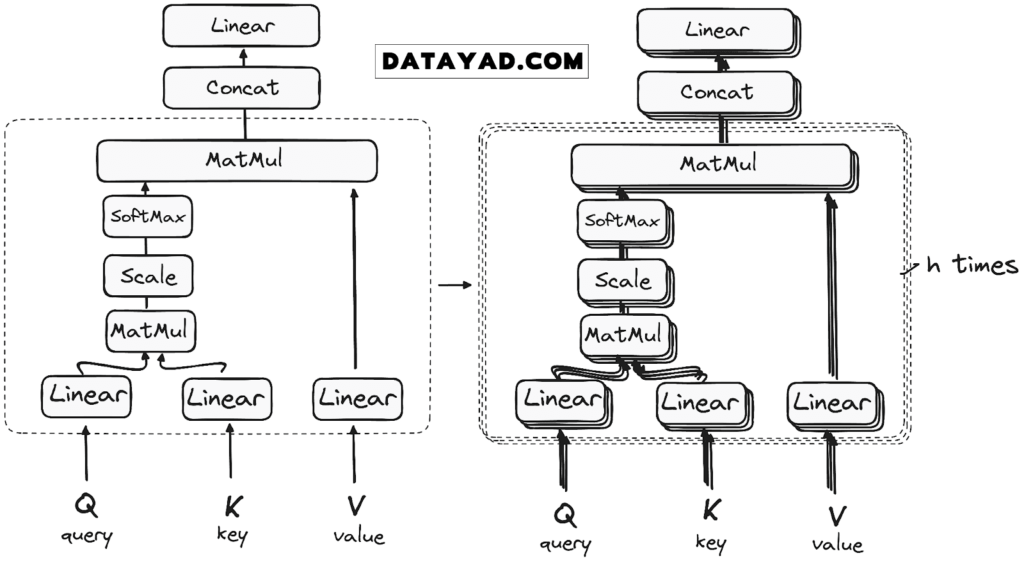
این ماژول خود توجهی به مدل امکان میدهد تا اطلاعات بافتی (contextual information) را از کل توالی استخراج کند. به جای انجام تنها یک تابع توجه، کوئریها، کلیدها و مقادیر به تعداد h بار به صورت خطی تصویر (projected) میشوند. مکانیزم توجه روی هر یک از این نسخههای تصویر شده به صورت موازی اجرا میشود و در نتیجه h خروجی متفاوت تولید میکند.
معماری دقیق این فرآیند به شرح زیر است:
۱. ضرب ماتریسی (MatMul) – ضرب نقطهای (Dot Product) کوئری و کلید
پس از اینکه بردارهای کوئری، کلید و مقدار از یک لایه خطی (linear layer) عبور کردند، یک عملیات ضرب ماتریسی نقطهای (dot product matrix multiplication) بین کوئریها و کلیدها انجام میشود که منجر به ایجاد ماتریس امتیاز (score matrix) میگردد.
ماتریس امتیاز مشخص میکند که هر کلمه باید چه میزان بر کلمات دیگر تأکید (توجه) داشته باشد. بنابراین، به هر کلمه امتیازی در رابطه با سایر کلمات در همان گام زمانی اختصاص مییابد. امتیاز بالاتر به معنای تمرکز بیشتر است. این فرآیند به طور مؤثر کوئریها را به کلیدهای مربوطهشان نگاشت (map) میکند.
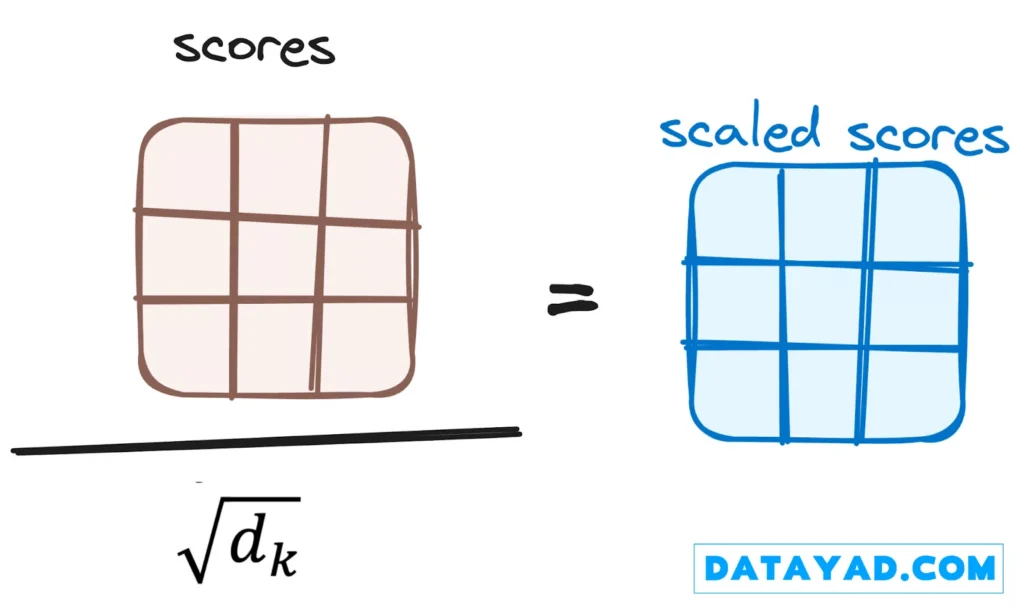
۲. کاهش مقیاس امتیازات توجه (Scaling)
سپس این امتیازات با تقسیم شدن بر جذرِ بُعدِ بردارهای کوئری و کلید (مثلاً جذر dk)، مقیاسدهی (scaled down) میشوند. این مرحله برای اطمینان از گرادیانهای پایدارتر پیادهسازی شده است، زیرا ضرب مقادیر در هم میتواند منجر به نتایج بسیار بزرگ و انفجاری شود.
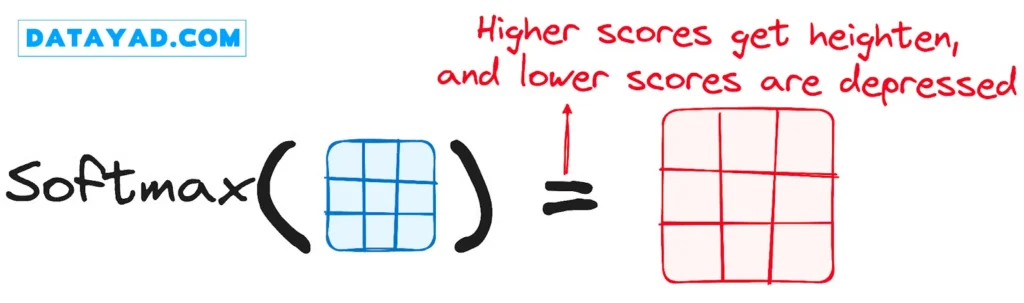
۳. اعمال تابع سافتمکس (Softmax)
در مرحله بعد، تابع سافتمکس روی امتیازات تنظیمشده اعمال میشود تا وزنهای توجه (attention weights) به دست آیند. این کار مقادیر احتمالی را در بازه ۰ تا ۱ نتیجه میدهد. تابع سافتمکس بر امتیازات بالاتر تأکید میکند و امتیازات پایینتر را کماهمیت جلوه میدهد، در نتیجه توانایی مدل را برای تعیین اینکه کدام کلمات باید توجه بیشتری دریافت کنند، افزایش میدهد.
۴. ترکیب نتایج سافتمکس با بردار مقدار (Value)
گام بعدی مکانیزم توجه این است که وزنهای بهدستآمده از سافتمکس در بردار مقدار (Value vector) ضرب میشوند که نتیجه آن یک بردار خروجی است.
در این فرآیند، در واقع فقط اطلاعات کلماتی که امتیاز سافتمکس بالایی دارند حفظ (و تقویت) میشوند. در نهایت، این بردار خروجی برای پردازش بیشتر به یک لایه خطی فرستاده میشود.
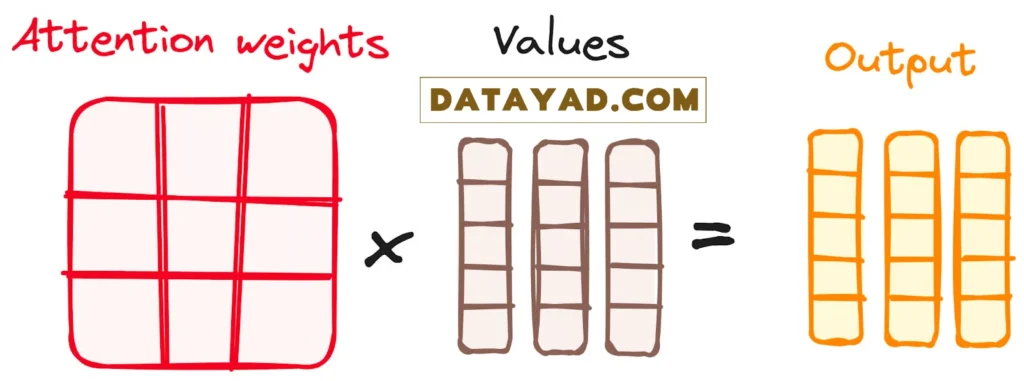
و به این ترتیب، ما خروجی مکانیزم توجه را به دست میآوریم!
خب، شاید بپرسید چرا به آن توجه چندگانه (Multi-Head Attention) میگویند؟
به یاد بیاورید که گفتیم قبل از شروع تمام این فرآیند، ما کوئریها، کلیدها و مقادیر را به h بخش تقسیم میکنیم. این فرآیند (که خود توجهی است) به صورت جداگانه در هر یک از این مراحل کوچکتر (یا heads) اتفاق میافتد. هر head به طور مستقل کار خود را انجام میدهد و یک بردار خروجی تولید میکند.
در نهایت، این مجموعه خروجیها (خروجی تمام headها) با هم ترکیب شده و از یک لایه خطی نهایی عبور میکنند، که مانند فیلتری عمل میکند که عملکرد جمعی آنها را تنظیم و نهایی میکند. زیبایی کار در اینجا، تنوع یادگیری در هر head است، که مدل رمزگذار را با درکی چندوجهی و مستحکم غنی میسازد.
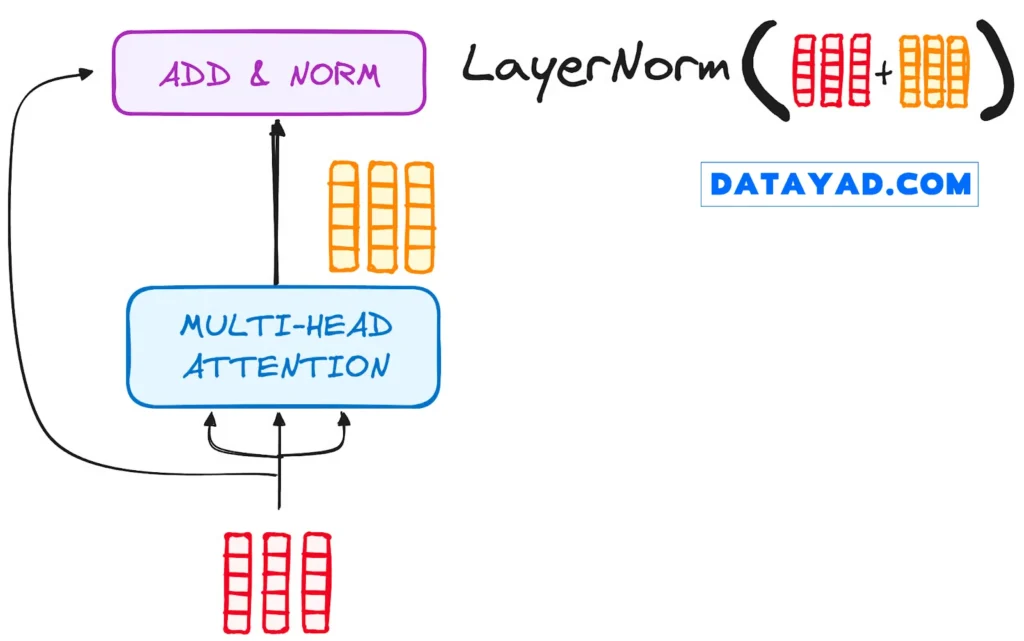
مرحله ۳.۲ – نرمالسازی و اتصالات Residual Connections
هر زیر-لایه (sub-layer) در لایه رمزگذار، با یک مرحله نرمالسازی (normalization) دنبال میشود. همچنین، خروجی هر زیر-لایه به ورودی خودش اضافه میشود (که به آن اتصال پسماند یا residual connection میگویند) تا به کاهش مشکل محو شدگی گرادیان (vanishing gradient) کمک کند و امکان ساخت مدلهای عمیقتر را فراهم سازد.
این فرآیند دقیقاً پس از شبکه (Feed-Forward) نیز تکرار خواهد شد.
مرحله ۳.۳ – شبکه عصبی Feed-Forward
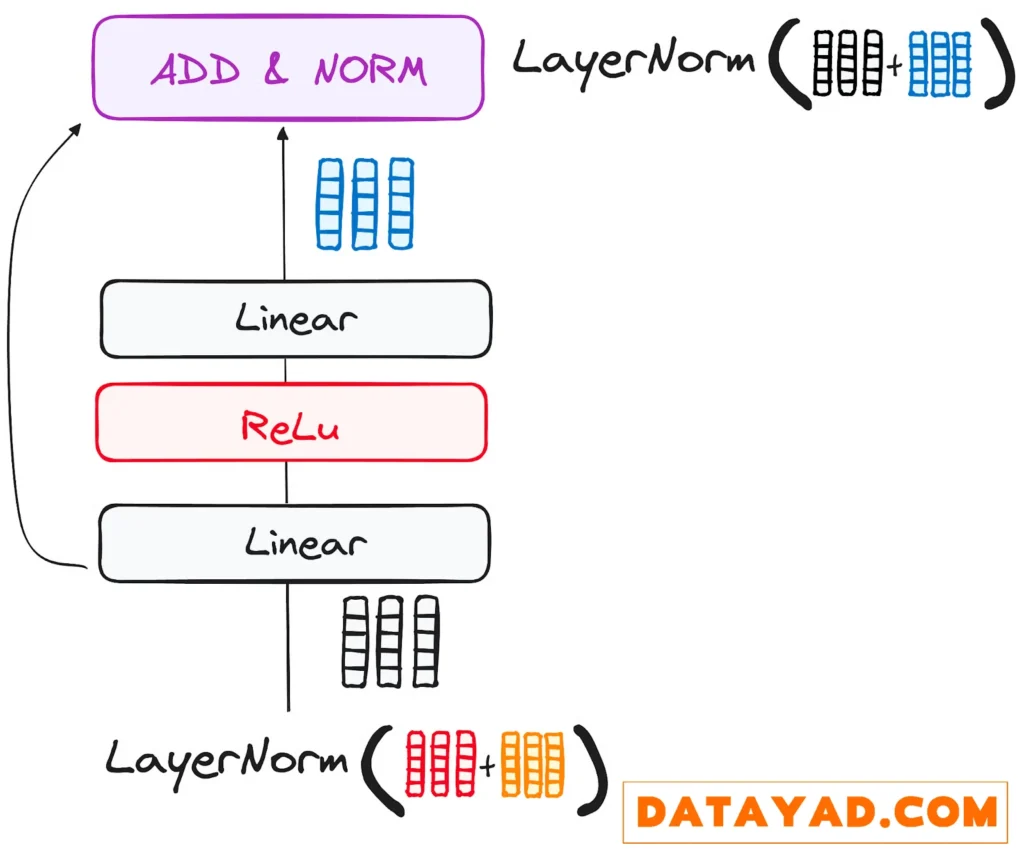
سفرِ خروجیِ (Normalization and Residual Connections)، با عبور از یک شبکه (pointwise feed-forward) ادامه مییابد که این مرحلهای حیاتی برای پالایش بیشتر اطلاعات است.
این شبکه را به عنوان مجموعهای دوتایی از لایههای خطی (linear layers) تصور کنید که یک تابع فعالسازی ReLU به عنوان پلی در میان آنها قرار گرفته است. پس از پردازش، خروجی یک مسیر آشنا را طی میکند: به عقب برمیگردد و با ورودیِ شبکه پیشخور نقطهای ادغام میشود.
به دنبال این ادغام، دور دیگری از نرمالسازی انجام میشود تا اطمینان حاصل شود که همه چیز برای مراحل بعدی به خوبی تنظیم و هماهنگ شده است.
مرحله ۴ – خروجی رمزگذار
خروجی لایه نهایی رمزگذار (final encoder layer)، مجموعهای از بردارها (vectors) است. هر یک از این بردارها، بازنمایی (representation) توالی ورودی است که با درک بافتی غنی همراه شده است.
این خروجی سپس به عنوان ورودی برای رمزگشا (decoder) در مدل ترنسفورمر (Transformer model) استفاده میشود. این رمزگذاری (encoding) دقیق، مسیر را برای رمزگشا هموار میسازد، و آن را راهنمایی میکند تا در زمان رمزگشایی (decoding)، به کلمات درستی در ورودی «توجه» کند.
این فرآیند را مانند ساختن یک برج تصور کنید، که در آن میتوانید N لایه رمزگذار را روی هم بچینید. هر لایه، فرصتی برای کاوش و یادگیری جنبههای مختلف توجه پیدا میکند. این کار نه تنها درک مدل را متنوع میسازد، بلکه میتواند قابلیتهای پیشبینی شبکه ترنسفورمر را به طور قابل توجهی تقویت کند.
نحوه کار رمزگشا (Decoder) در مدل ترنسفورمر
نقش رمزگشا (Decoder) بر ساختن توالیهای متنی متمرکز است. Decoder، دقیقاً مانند Encoder، به مجموعهای مشابه از زیرلایهها مجهز شده است. این بخش دارای دو لایه (multi-headed attention)، یک لایه (pointwise feed-forward) است و همچنین از(residual connections) و نرمالسازی (layer normalization) بعد از هر زیرلایه استفاده میکند.
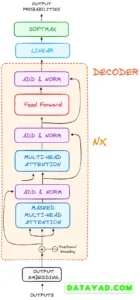
این اجزا شبیه به لایههای رمزگذار عمل میکنند، اما با یک تفاوت کلیدی: هر لایه توجه چندگانه در رمزگشا، مأموریت منحصربهفرد خود را دارد.
فرآیند نهایی رمزگشا شامل یک لایه خطی (linear layer) است که به عنوان طبقه بند یا classifier عمل میکند و در انتها با یک تابع سافتمکس (softmax) برای محاسبه احتمالات کلمات مختلف، تکمیل میشود.
رمزگشای ترنسفورمر (Transformer decoder) ساختاری دارد که به طور خاص برای تولید این خروجی از طریق رمزگشایی (decoding) گامبهگام اطلاعات رمزگذاریشده (encoded) طراحی شده است.
توجه به این نکته بسیار مهم است که رمزگشا به صورت خودهمبسته (autoregressive) عمل میکند، یعنی فرآیند خود را با یک توکن شروع میکند.
این بخش هوشمندانه، لیستی از خروجیهایی که قبلاً تولید کرده است را به عنوان ورودیهای جدید خود استفاده میکند، البته در کنار خروجیهای رمزگذار که سرشار از اطلاعات توجه از ورودی اولیه هستند.
این کار تا زمانی ادامه مییابد که رمزگشا به یک لحظه حیاتی برسد: تولید توکن پایانی که سیگنال اتمام تولید خروجی است.
مرحله ۱ – تعبیهسازیهای خروجی (Output Embeddings)
در خط شروعِ رمزگشا، فرآیند، مشابه رمزگذار است. در اینجا، ورودی (که در گام اول همان توکن شروع و در گامهای بعدی، کلمه تولید شده قبلی است) ابتدا از یک لایه تعبیهسازی (embedding layer) عبور میکند.
مرحله ۲ – رمزگذاری موقعیتی (Positional Encoding)
پس از تعبیهسازی، باز هم درست مانند رمزگذار، ورودی از لایه رمزگذاری موقعیتی عبور میکند. این توالی برای تولید تعبیهسازیهای موقعیتی (positional embeddings) طراحی شده است.
این تعبیهسازیهای موقعیتی سپس به اولین لایه توجه چندگانه در رمزگشا هدایت میشوند، جایی که امتیازات توجه مخصوص ورودی رمزگشا به دقت محاسبه میشود.
مرحله ۳ – پشته لایههای رمزگشا (Stack of Decoder Layers)
رمزگشا از پشتهای از لایههای یکسان تشکیل شده است (در مدل ترنسفورمر اصلی، ۶ لایه بود). هر لایه دارای سه زیر-جزء اصلی است:
مرحله ۳.۱ – مکانیزم Masked Self-Attention
این مکانیزم شبیه به مکانیزم خود توجهی در رمزگذار است اما یک تفاوت حیاتی دارد: این مکانیزم موقعیتها (کلمات) را از توجه کردن به موقعیتهای بعدی (کلمات آینده) باز میدارد. این یعنی هر کلمه در توالی، تحت تأثیر توکنهای آینده قرار نمیگیرد.
به عنوان مثال، زمانی که امتیازات توجه برای کلمه «are» در حال محاسبه است، بسیار مهم است که «are» نتواند نگاهی به «you» بیندازد، که کلمهای بعدی در توالی است.
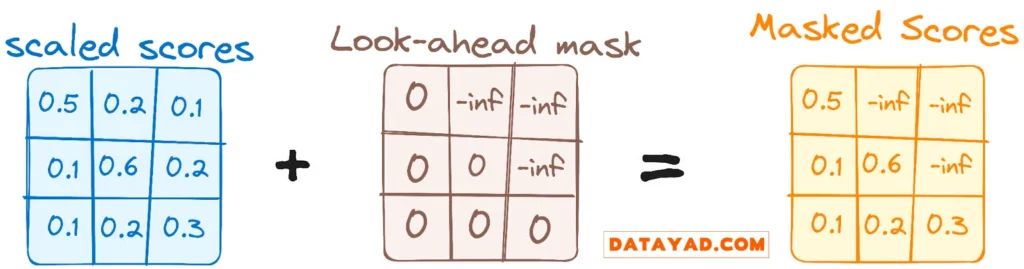
این ماسکگذاری (masking) تضمین میکند که پیشبینیها برای یک موقعیت خاص، فقط میتوانند به خروجیهای شناختهشده در موقعیتهای قبل از آن وابسته باشند.
مرحله ۳.۲ – توجه چندگانه رمزگذار-رمزگشا (Encoder-Decoder Attention) یا توجه متقابل (Cross Attention)
در دومین لایه توجه چندگانه در رمزگشا، ما شاهد یک تعامل منحصربهفرد بین اجزای رمزگذار و رمزگشا هستیم.
در اینجا، خروجیهای رمزگذار نقش کوئری (Queries) و کلید (Keys) را بر عهده میگیرند، در حالی که خروجیهای لایه اول توجه چندگانه در رمزگشا (یعنی لایه ماسکدار قبلی)، نقش مقدار (Values) را ایفا میکنند.
این تنظیمات به طور مؤثری ورودی رمزگذار را با رمزگشا همتراز میکند و به رمزگشا این قدرت را میدهد که مرتبطترین بخشهای ورودی رمزگذار را شناسایی کرده و بر آنها تأکید کند.
به دنبال آن، خروجی این لایه دوم توجه چندگانه، از طریق یک لایه (pointwise feedforward) پالایش میشود تا پردازش را بیشتر بهبود بخشد.
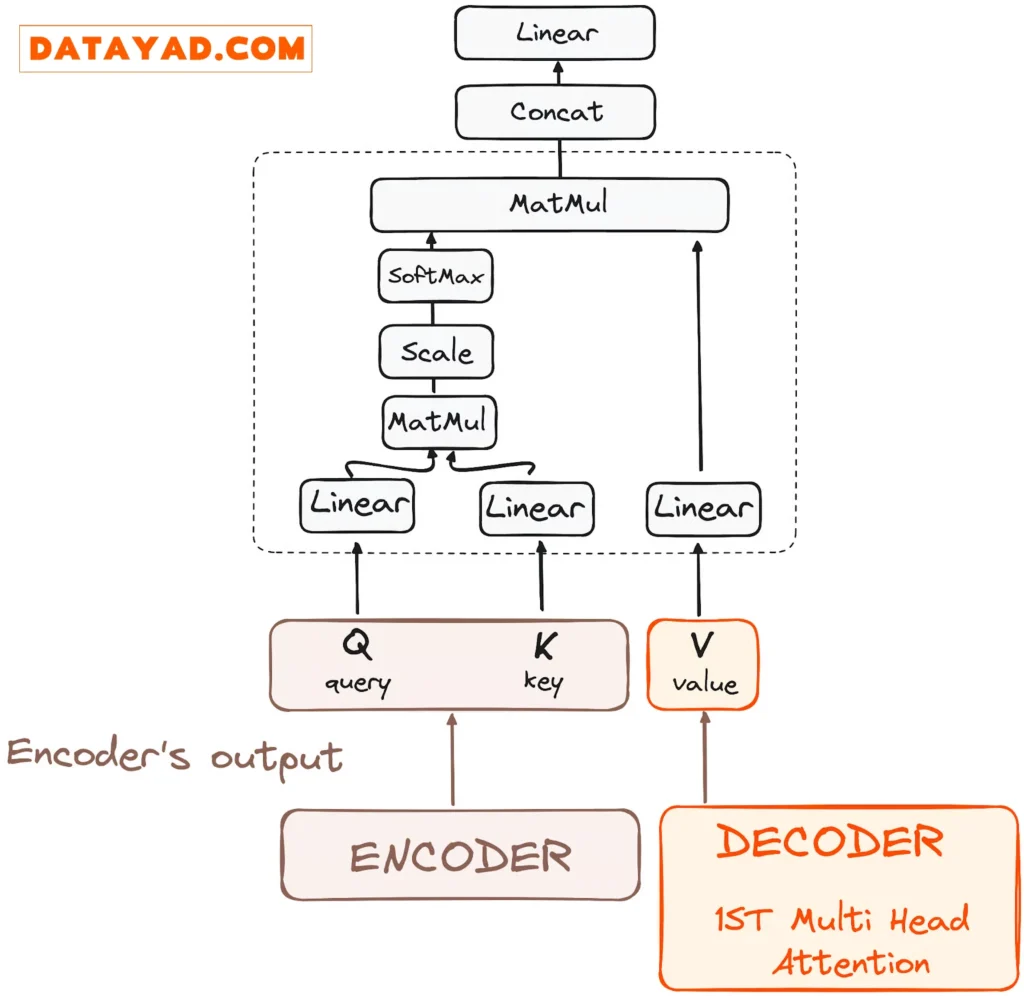
توضیح فنیتر: در این زیرلایه، کوئریها از لایه قبلی رمزگشا میآیند، و کلیدها و مقادیر از خروجی رمزگذار میآیند. این به هر موقعیت در رمزگشا اجازه میدهد تا به تمام موقعیتها در توالی ورودی (انکودر) توجه کند و به طور مؤثری اطلاعات رمزگذار را با اطلاعات رمزگشا ادغام کند.
مرحله ۳.۳ – شبکه عصبی پیشخور Feed-Forward
مشابه رمزگذار، هر لایه رمزگشا نیز شامل یک شبکه پیشخور کاملاً متصل است که به طور جداگانه و یکسان برای هر موقعیت (توکن) اعمال میشود.
مرحله ۴ – طبقهبند خطی و سافتمکس برای تولید احتمالات خروجی
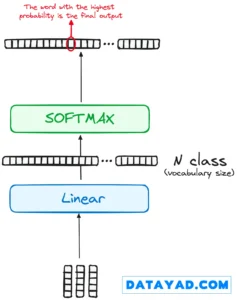
سفر دادهها در مدل ترنسفورمر با عبور از یک لایه خطی نهایی به اوج خود میرسد، که این لایه به عنوان یک طبقهبند (classifier) عمل میکند.
اندازه این طبقهبند با تعداد کل کلاسها (یعنی تعداد کلمات موجود در واژگان (vocabulary)) مطابقت دارد. به عنوان مثال، در سناریویی با ۱۰۰۰ کلاس مجزا که نشاندهنده ۱۰۰۰ کلمه متفاوت هستند، خروجی طبقهبند آرایهای با ۱۰۰۰ عنصر خواهد بود.
این خروجی سپس به یک لایه سافتمکس (softmax) داده میشود، که آن را به مجموعهای از امتیازات احتمالی تبدیل میکند که هر کدام بین ۰ و ۱ قرار دارند. بالاترین امتیاز در این مجموعه، کلیدی است، شاخص (index) متناظر با آن، مستقیماً به کلمهای اشاره میکند که مدل به عنوان کلمه بعدی در توالی پیشبینی میکند.
فراموش نکنید که هر زیرلایه (شامل خود توجهی ماسکدار، توجه رمزگذار-رمزگشا و شبکه پیشخور) با یک مرحله نرمالسازی دنبال میشود، و همچنین هر کدام دارای یک اتصال پسماند در اطراف خود هستند.
خروجی رمزگشا (Output of the Decoder)
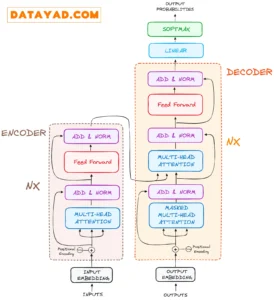
خروجی لایه نهایی به یک توالی پیشبینیشده تبدیل میشود، که معمولاً از طریق یک لایه خطی و سپس سافتمکس برای تولید احتمالات بر روی واژگان انجام میشود.
رمزگشا، در جریان عملیاتی خود، خروجی تازهتولیدشده را به لیست ورودیهای در حال رشد خود اضافه میکند و سپس فرآیند رمزگشایی را ادامه میدهد. این چرخه تا زمانی تکرار میشود که مدل توکن خاصی را پیشبینی کند که نشاندهنده تکمیل فرآیند است.
توکنی که با بالاترین احتمال پیشبینی میشود، به عنوان کلاس نهایی در نظر گرفته میشود که اغلب با توکن پایان (end token) نشان داده میشود.
باز هم به یاد داشته باشید که رمزگشا به یک لایه محدود نمیشود. میتوان آن را با N لایه ساختاردهی کرد، که هر لایه بر اساس ورو
دی دریافتی از رمزگذار و لایههای قبلی خود ساخته میشود. این معماری لایهای به مدل اجازه میدهد تا تمرکز خود را متنوع کند و الگوهای توجه متفاوتی را در واحدهای توجه(attention heads) خود استخراج کند.
چنین رویکرد چندلایهای میتواند به طور قابل توجهی توانایی پیشبینی مدل ترنسفورمر را افزایش دهد، زیرا درک دقیقتری از ترکیبهای مختلف توجه (attention) ایجاد میکند.
این مقاله فقط یک نقطه شروع است. اگر آمادهاید که تمام مفاهیم مکانیزم توجه (attention mechanism) و ترنسفورمرها را به صورت کاملاً عملی بیاموزید، جزئیات دوره LLM دیتایاد را بررسی کنید و در صورت تمایل از مشاوران ما راهنمایی دریافت کنید.
سوالات متداول درباره مدل ترنسفورمر
۱. مدل ترنسفورمر چیست و چه کاربردی دارد؟
مدل ترنسفورمر نوعی معماری شبکه عصبی پیشرفته در یادگیری عمیق است که با استفاده از مکانیزم توجه، الگوها و روابط بین کلمات را درک میکند و پایه و اساس ابزارهایی مثل ChatGPT، سیستمهای ترجمه ماشینی و مدلهای زبانی بزرگ است.
۲. تفاوت اصلی مدل ترنسفورمر با شبکههای RNN چیست؟
مدلهای RNN متن را کلمه به کلمه و پشتسرهم پردازش میکنند که سرعت پایینی دارد، اما ترنسفورمر تمام کلمات را به صورت همزمان و موازی پردازش میکند و وابستگیهای بین کلمات طولانی را بسیار بهتر تشخیص میدهد.
۳. مکانیزم خودتوجهی (Self-Attention) در ترنسفورمر چگونه کار میکند؟
مکانیزم خودتوجهی با بررسی ارتباط هر کلمه با سایر کلمات موجود در جمله، میزان اهمیت و وزن کلمات را نسبت به هم میسنجد تا مفهوم دقیقتری از متن به دست آید.
۴. دو بخش اصلی در معماری ترنسفورمر کدامند؟
این معماری از دو بخش اصلی رمزگذار (Encoder) برای فهم و استخراج ویژگیهای ورودی و رمزگشا (Decoder) برای تولید پاسخ و خروجی متنی تشکیل شده است.
۵. آیا از ترنسفورمرها فقط در متن و NLP استفاده میشود؟
خیر؛ اگرچه ترنسفورمر در ابتدا برای پردازش زبان طبیعی ابداع شد، اما امروزه در بینایی کامپیوتر (Vision Transformers)، پردازش صوت، کدنویسی و تولید موسیقی هم کاربرد وسیعی دارد.
یادگیری مدلهای ترنسفورمر را از کجا شروع کنیم؟
آشنایی با مبانی تئوری، ساختار رمزگذار و رمزگشا و مکانیزم خودتوجهی گام اول است؛ اما چالش اصلی زمانی آغاز میشود که بخواهید این معماریها را در پروژههای واقعی هوش مصنوعی پیادهسازی و اجرا کنید. برای ورود به بازار کار و توسعه مدلهای زبانی، نیاز به یادگیری مهارتهای عملی و مدرن دارید.
در دوره LLM و NLP با پایتون دیتایاد، تمامی مباحث از تسلط کامل بر ترنسفورمرها و پیادهسازی لایهها تا تنظیم دقیق مدلها و اجرای پروژههای پیشرفته پوشش داده شده است تا مهارت فنی خود را به پروژههای کاربردی تبدیل کنید.
- آموزش عمیق و کاربردی معماری ترنسفورمرها و پردازش زبان طبیعی مدرن
- آموزش عملی تنظیم دقیق (Fine-Tuning) مدلهای زبانی بزرگ برای سناریوهای اختصاصی
- پیادهسازی و ساخت سیستمهای پیشرفته مبتنی بر RAG
- توسعه چتباتها و سیستمهای پرسش و پاسخ برای زبانهای فارسی و انگلیسی
- ساخت پروژههای کاربردی مثل خلاصهسازی کامنتها و پردازش هوشمند متون